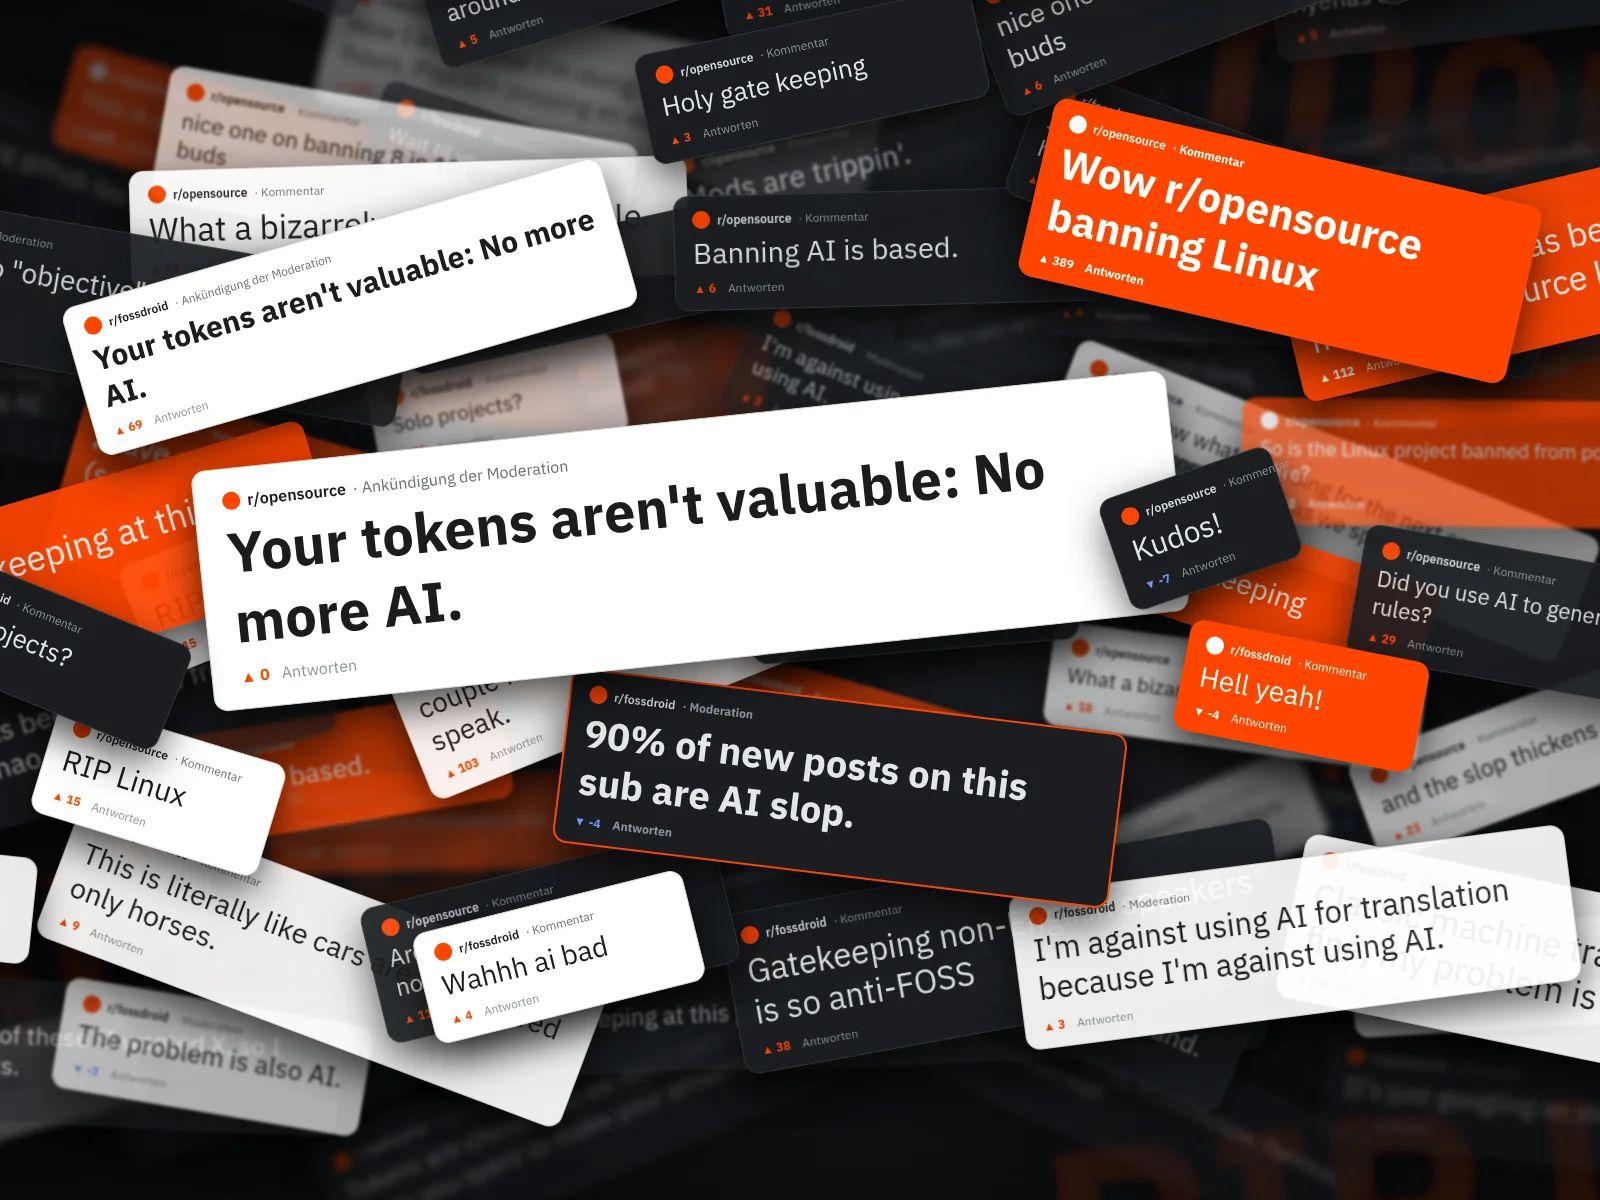
Auf Reddit ist r/opensource so etwas wie der Stammtisch der Open-Source-Welt, die größte Community zum Thema auf der Plattform. Am Wochenende hat dort der Lead-Mod Wolvereness neue Regeln verkündet. Die Ankündigung trägt den Titel „Your tokens aren’t valuable: No more AI.“ und macht die Tür für KI-gestützte Projekte zu. Die Begründung passt in einen Satz: KI, wie sie heute existiere, sei mit dieser Open-Source-Community unvereinbar.
Kurz darauf zog r/fossdroid nach, die Anlaufstelle für freie Android-Apps. Die dortige Moderation hat die Regeln in ihrer Ankündigung Wort für Wort übernommen, nur der Name des Subreddits ist ein anderer. KI sei dort ohnehin nie erlaubt gewesen. In den Kommentaren legt die Moderation nach: Neun von zehn neuen Beiträgen seien KI-Schrott, und aussortiert werde alles von Hand.
Was die neuen Regeln verlangen
Die Ankündigung bei r/opensource geht weit über KI hinaus. Ein Projekt muss mindestens ein Jahr alt sein und aktiv gepflegt werden, mehrere Mitwirkende haben und auf eine bestehende Community verweisen. Schulprojekte und Software für KI, etwa MCP-Server, fliegen raus. Wer postet, braucht ein mindestens ein Jahr altes Reddit-Konto mit nennenswerter Aktivität. Und wer kein Englisch spricht, soll sich eine andere Community suchen.
Der Kern steht in einem Satz: „If it’s obvious you’re using AI in your project, we don’t want it.“ Dahinter folgt der Seitenhieb aus dem Titel: „Tokens are cheap, and we don’t care how many you spent to make your amazing project.“ Wer KI-Beiträge postet oder per Modmail um eine Ausnahme bettelt, fliegt dauerhaft. Von den Mindestanforderungen befreit sind nur offiziell eingetragene gemeinnützige Organisationen.
Bei r/fossdroid ist die Sprachregel inzwischen durchgestrichen. Stattdessen steht dort nun, es gehe nicht um Sprache oder Herkunft, sondern allein um KI. Klassische maschinelle Übersetzung sei erlaubt, eine per Sprachmodell nicht. Ob DeepL oder Google Translate da noch als klassisch durchgehen, sei mal dahingestellt. Beide arbeiten seit Jahren mit neuronalen Netzen, und Reddit übersetzt Beiträge inzwischen selbst.
Wie es zu den Regeln kam, beschreibt Dan Brown, Entwickler von BookStack und bis vor Kurzem selbst Moderator von r/opensource, in seinem Blog. Laut Brown stammen die Regeln allein von Wolvereness, mit dem restlichen Team sei nichts abgesprochen worden. Brown hält die KI-Regel für nicht durchsetzbar und die Sprachregel für verletzend. Als Moderator hat Brown sich inzwischen zurückgezogen.
Linus Torvalds sieht das ganz anders
Pikant ist der Zeitpunkt. Der Linux-Kernel geht gerade den umgekehrten Weg. Auf dem Maintainers Summit am 8. Oktober in Prag gab es eine Mehrheit dafür, den „Assisted-by“-Tag für KI-unterstützte Patches wieder zu streichen. Nur rund zehn Prozent der 18.533 Commits für Linux 7.3 bis zum -rc7 tragen ihn, eingesetzt wird KI laut Sasha Levin aber deutlich häufiger. Den KI-Einsatz sollen Entwickler künftig im Cover-Letter beschreiben.
Linus Torvalds selbst hält Regeln nach dem Muster „don’t use AI for X“ für idiotisch und erwartet stattdessen, dass Entwickler verstehen, was sie tun. Am 13. Oktober hat er eine Serie aus zehn Patches eingereicht, die er nach it-daily mit Claude Code entwickelt hat. Prüfer fanden darin prompt eine Race Condition. Die Kernel-Entwickler nutzen KI also ganz offen, nur eben mit Review.
Kein Wunder, dass „Wow r/opensource banning Linux“ unter der Ankündigung zu den meistbewerteten Kommentaren gehört. Auf die ernst gemeinte Nachfrage, wie es denn mit dem Kernel aussehe, antwortete Wolvereness, der wäre „on the subjective line“ wohl erlaubt. Sprich, KI ist verboten, außer die Mods drücken ein Auge zu. Einen objektiven Maßstab gebe es nicht, räumt Wolvereness an anderer Stelle selbst ein.
Was die Community dazu sagt
Der Gegenwind ist heftig. Die Ankündigung steht bei null Punkten, der Top-Kommentar bei über 1.400: „This is orthogonal to open source.“ Ob Software frei ist, entscheidet die Lizenz und nicht das Werkzeug. Ein anderer User pflegt seit neun Jahren ein Paket mit über 300 Sternen auf GitHub, ganz ohne KI. Es fliegt trotzdem raus: nur ein Maintainer.
Mindestens genauso viel Ärger zieht die Sprachregel auf sich, viele nennen sie schlicht fremdenfeindlich. Ein User aus Japan schreibt bewusst von Hand in holprigem Englisch, dass Übersetzungsdienste auch zum Lesen nötig sind, um die anderen überhaupt zu verstehen. Und die Ausnahme für eingetragene Organisationen legen Kritiker so aus, dass große Projekte KI nutzen dürfen, einzelne Entwickler aber nicht.
Es gibt aber auch Zustimmung. Vor allem das Ende der ewigen „I got tired of X so I built Y“-Posts begrüßen viele, und einige sind froh, dass endlich jemand durchgreift. Ein Kommentator bei r/fossdroid argumentiert, zusammengepromptete Apps würden nie die Pflege bekommen, die Entwickler ihren eigenen Projekten geben. Dem halten andere entgegen, dass auch von Hand geschriebene FOSS-Projekte reihenweise einschlafen.
Die Chance: Tempo für Projekte ohne Nachwuchs
Ich kann beide Seiten verstehen. Auf der einen Seite bietet der Einsatz von Sprachmodellen in der Softwareentwicklung enorme Chancen. Es geht einfach enorm schnell, und ja, es kommt auch sehr brauchbarer Code heraus. „Tokens are cheap“ stimmt dabei übrigens nur bedingt: Ein Softwareentwickler im Ruhestand rechnet im Thread vor, für das eigene Open-Source-Projekt 200 Dollar im Monat an KI-Abo zu zahlen.
Gerade bei Projekten, bei denen die freiwilligen Entwickler nicht gerade Schlange stehen, ist das eine riesige Chance. Bei r/fossdroid nennt jemand die eigene App ShizuCallRecorder als Beispiel: 2.000 Sterne auf GitHub, über 103.000 Downloads, aber nur zwei Pull-Requests mit Code von außen, beide mit KI-Hilfe entstanden. Wie soll so ein Projekt auf drei Mitwirkende kommen? Ein pauschales Verbot trifft ausgerechnet diese Leute.
Mehr Lücken gefunden, weniger neue eingebaut
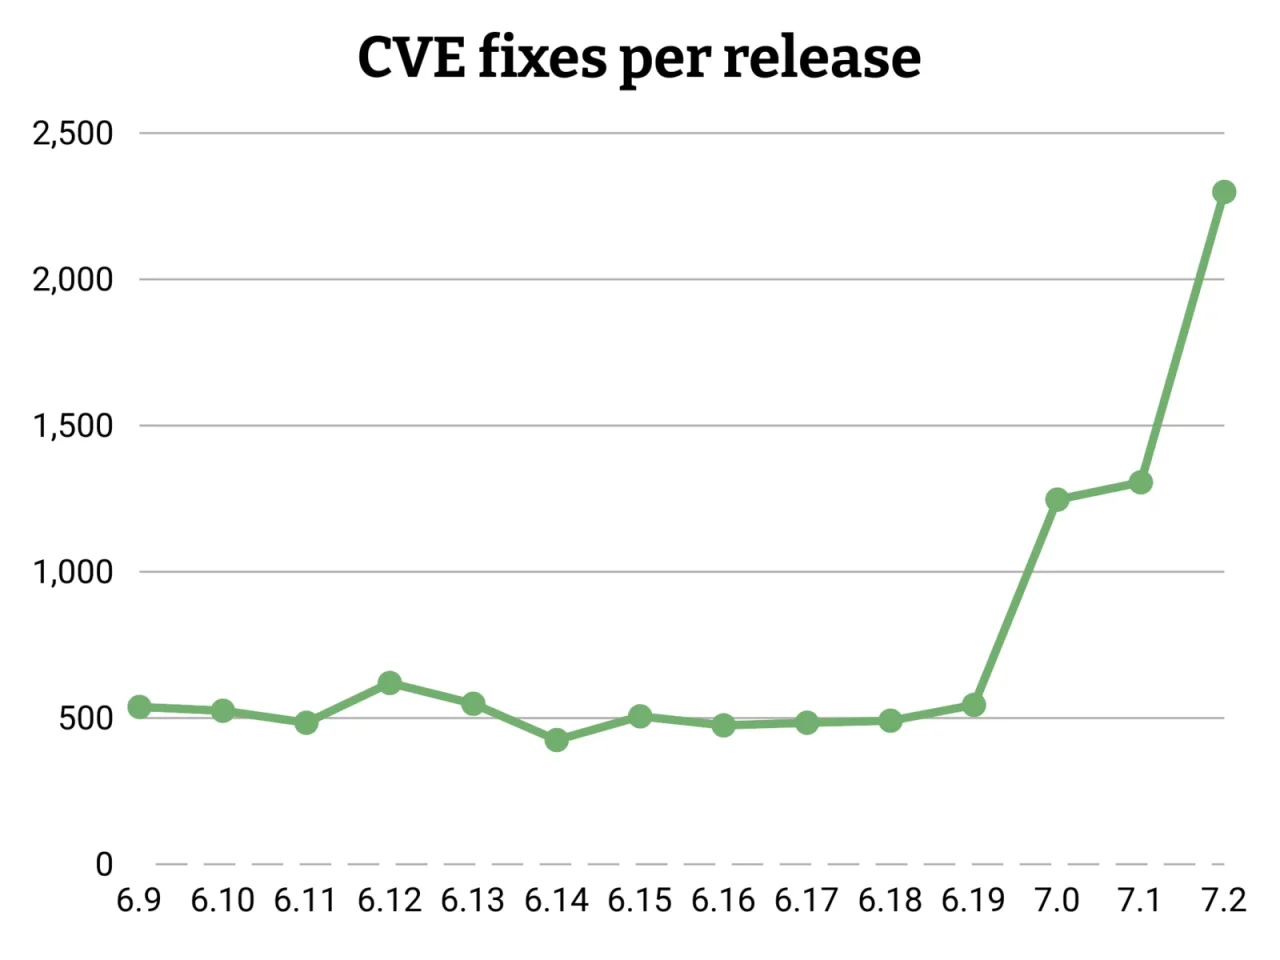
Was KI für die Sicherheit bringen kann, zeigen zwei Grafiken, die Greg Kroah-Hartman in seinem Repository zur Kernel-Entwicklung veröffentlicht. Bis Linux 6.19 kamen pro Version konstant rund 500 Korrekturen für CVE-Lücken zusammen. Mit 7.0 springt der Wert auf über 1.200, mit 7.2 auf rund 2.300. Es dürfte kein Zufall sein, dass das in die Zeit fällt, in der KI-Werkzeuge für Entwicklung und Codeanalyse Fahrt aufnehmen.
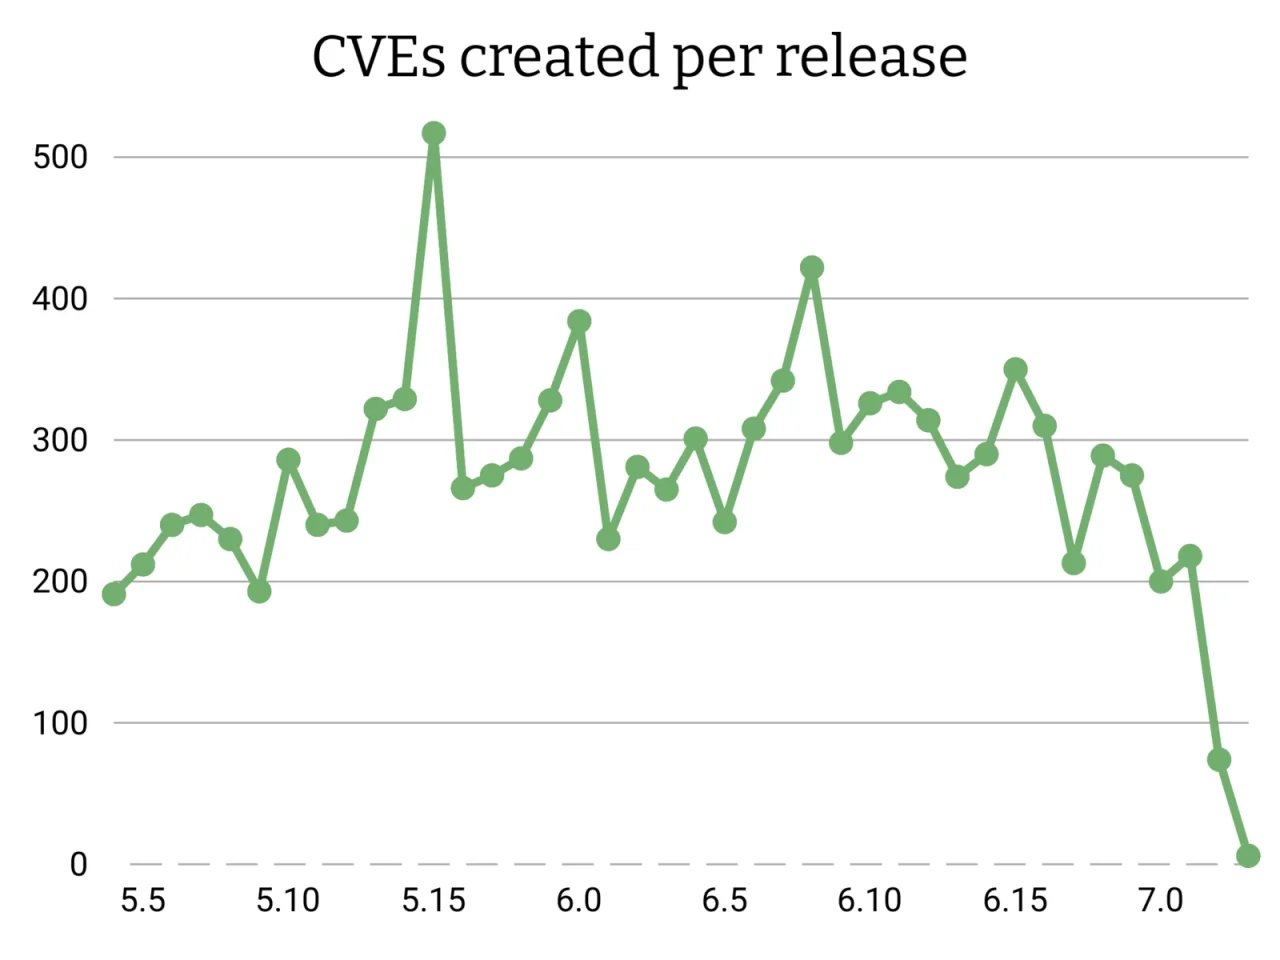
Die zweite Grafik zählt die CVEs nach der Kernel-Version, in der sie entstanden sind. Die Kurve zeigt seit Linux 6.15 nach unten, für die jüngsten Versionen liegt sie fast bei null. Sprich, es werden immer mehr alte Lücken aufgedeckt, während neuer Code weniger neue mitbringt. Klar, ganz vorn ist das mit Vorsicht zu genießen: Fehler in frischem Code fallen oft erst Jahre später auf.
Für mich ist das trotzdem das stärkste Argument gegen ein Pauschalverbot. Ein Sprachmodell, das bestehenden Code liest und darin Fehler aufspürt, macht freie Software sicherer, nicht unsicherer. Torvalds nutzt KI nach eigener Aussage auch, um schwer nachvollziehbare Patches zu verstehen. Entscheidend bleibt, dass am Ende ein Mensch die Korrektur prüft und dafür geradesteht. Das gilt für den Kernel genauso wie für die kleine Android-App.
Die Kehrseite: Irgendjemand muss den Code lesen
Auf der anderen Seite kann ich die Mods auch verstehen. Irgendjemand muss den KI-Code auch sichten. Ungeprüft jeden Code in ein Projekt durchzureichen, widerspricht irgendwie dem Open-Source- und dem Sicherheitsgedanken. Der Witz an freier Software ist ja gerade, dass jeder hineinschauen kann und es auch jemand tut. Code, den nicht einmal sein eigener Autor gelesen hat, kehrt dieses Prinzip um.
Wird Software wieder zur Blackbox, dann kann man auch gleich wieder Closed Source verwenden. Mit dem Sprachmodell in einer Nacht ein Projekt zusammenzuklicken und die Prüfung dann Moderatoren, Paketbetreuern oder Maintainern vor die Füße zu werfen, ist von daher nicht die feine englische Art. Der Aufwand verschwindet ja nicht. Er landet nur bei anderen, und die machen das meistens ebenfalls ehrenamtlich.
Ein KI-Gegner bei r/fossdroid trifft den Punkt, eigentlich als Argument gegen den Werkzeug-Vergleich: Selbst Torvalds verlange, dass KI-Ausgaben geprüft werden. Einen Compiler müsse dagegen niemand kontrollieren. Ein anderer vergleicht KI mit einem nicht allzu hellen Junior-Entwickler. Dessen Arbeit kann man ungesehen ausliefern, oder man prüft sie gründlich und steuert nach, bis sie taugt. Genau zwischen diesen beiden Wegen verläuft für mich die Grenze.
Verantwortung statt Verbot
In meinen Augen trifft der Kernel den Punkt besser als r/opensource. Dort darf jeder ein Sprachmodell nutzen, aber ein Mensch trägt die Verantwortung für jeden Beitrag und muss ihn selbst per Signed-off-by abzeichnen. Sprich, nicht das Werkzeug entscheidet, sondern ob jemand seinen Code verstanden hat. Dass die Prüfer bei Torvalds‘ Patches eine Race Condition gefunden haben, zeigt ja gerade, warum das Review bleiben muss.
Klar, ein Subreddit ist kein Kernel, und die Flut an Schrottprojekten, Werbung und Bot-Accounts ist echt. Gute Vorschläge stehen aber in den Threads selbst: Wer ein Projekt vorstellt, soll eine Demo, funktionierende Installationsschritte und eine kurze Erklärung mitliefern, sonst fliegt der Post. Das prüft man in Sekunden, und Schrott fällt dabei auf, egal ob von Mensch oder Maschine. Wie seht ihr das? Btw: Der Aufmacher? Natürlich KI-generiert 😉
Schreibe einen Kommentar